写在前面
AI 与人的结合最终会落进专业工作流,创意领域似乎已经软着陆,没有引来太大的冲击:2022 年 12 月,艺术家把“No AI Art”的图片放进 ArtStation 的作品集,一场抗议由此开始1。随后是授权交易与版权诉讼;再后来,协作逐渐在专业工作流里稳定下来2。当年抗议的那批人,现在也很少发声了。生态并没有因此更健康:和解是钱买来的,诉讼仍在继续3。以音乐行业为例:UMG 与 Udio 和解并签下授权协议,Warner 与 Suno 和解,而 Sony 的诉讼还在马萨诸塞州继续,2026 年 3 月又有新的起诉案件3。
这一次 AI 进入的是科研,粗看与上一波大同小异:科研也是创意工作。但不同的是,它有一套更古老的规矩。与此同时,科研要面对的问题更棘手:它的过程不可见,而且找不到一个统一的谈判对象。我们要问的是,当 AI 成为科研的协作者,什么样的收集与发表方式可以接受。我没法预测 AI 什么时候能真正独立做出重大成果,也无力评估具体公司的模型能力,更不打算卷进哪条技术路线更值得走的争论里。
我认为:收集科研轨迹本身不是问题,但用什么方式取得成果、又用什么方式宣告成果,会决定后果。接下来按事实、机制、制度三层,问三个问题:
- 谁在收集数据,价格是多少,实际得到了什么;
- 引用与致谢这套追溯办法,为什么脆弱、又为什么还能修;
- 逐篇核查已经追不上生成速度之后,我们手上还剩什么办法。
神龙见首不见尾:一份从未被完整记录过的过程
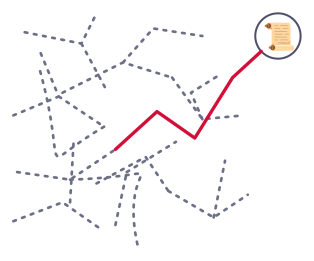
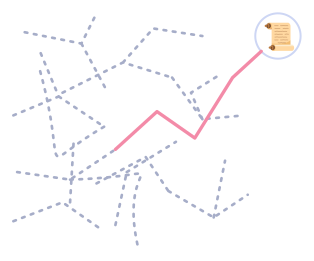
简单来说,科研是这样一份工作:成果写在论文里,来时路上的岔路与断头路不在其中,神龙见首不见尾(见下图)。
一条路径,与它周围的岔路
红线是被写进论文的路径,灰色虚线为其他失败或被选择跳过的方案,白色圆圈内才是最后发表的结果。
一条路径,与它周围的岔路
红线是被写进论文的路径,灰色虚线为其他失败或被选择跳过的方案,白色圆圈内才是最后发表的结果。
在传统的创意工作流程中,作品本身就是全部。笔触、编排与镜头调度只存在于作品里,外人看不出落笔的顺序。科研的过程同样难以完整还原,你无法从一篇发表的文章里看出初稿的形态,也看不出作者放弃过哪些方向、在哪些地方撞过墙。过程也留下过痕迹,只是散在会议走廊、邮件列表、实验室白板这些地方,也散在导师与学生的口头讨论里,时间一长,多数就只剩当事人的记忆与致谢栏里的一行字。
与此同时,科研重视积累与传播,每一步有价值的进展都留下记录:论文、预印本、会议报告与教科书,文字和图像把结论记得清清楚楚。这看起来是好事,但也同样意味着只看得见结果,看不见来路。
更麻烦的是,即便留下记录,我们能拿到的也多半不完整。实验记录本写下了做了什么,却很少写为什么放弃另一条路;代码仓库留下了最终版本,中间那些失败的分支通常早已被删掉。这些省略大多只是没地方写,并不都是有意隐瞒。
科研到底还是创意工作,只是这一点常被严谨的外表盖住:它的产出靠的是此前没有过的组合,而组合能不能成立,要试了才知道。这种不可见的过程,恰好是稀缺资源。陶哲轩在 2026 年 9 月 8 日写道:“it is now the identification of a promising problem which is the scarce and precious resource.”4 如果说此前稀缺的是算力,那么现在稀缺的是识别一个好问题的能力。这种识别能力是在试错里长出来的,而试错恰恰是最难记录、也最难定价的那部分,我们后来看到的,只有最终成立的那个问题。科研轨迹记下的,正是被放弃的那些尝试。
产业侧已经给出了价格信号。专门给 AI 实验室对接领域专家的数据公司 Mercor,2026 年 6 月的
下一个风口:席位、价格与可审计的产物
科研轨迹数据,Anthropic 已经开始收了。2026 年 8 月 27 日,它宣布了一项面向科学家的支持计划:学术或非营利研究机构的
这些动作加在一起,不太像做慈善:免费与低价的席位换回两类资产,一是真实问题的分布,二是科研轨迹的样本。前者决定下一版模型该往哪儿练,后者决定它能不能学会像研究者一样思考。研究者的判断力没法被大规模地、在真实场景下采样,只能一次次在真实问题上被记录下来。
而对研究者来说,这些条件也很诱人:一个能读完全部文献、随时回答问题的助手,以极低价格乃至免费提供给你,还附带算力额度。接受它的人不会觉得自己在出让什么,我们也很难去指责他们。
根据科研工作台 Claude Science 的官方说法,是把研究过程留成
2025 年 8 月,xAI 把 Grok Code Fast 1 限时免费开放给多家编程工具的用户,API 定价压到每百万输入 token 0.20 美元、每百万输出 token 1.50 美元8;Google 的 Gemini CLI 更直接:用个人账号登录,就有每分钟 60 次、每天 1,000 次的免费请求额度9。免费也是一种价格,收的正是轨迹。先用低价换使用,再把使用留下的轨迹拿去练下一代模型,这条路早已经在编程工具上演练过。对厂商来说,专家判断可以花钱买到,科研轨迹却不在公开市场上,只能靠产品体验换。
照这个势头,一年半载内,国内外厂商会集体推进收集。价格战会先来,接着是席位数量的跃迁,再接着,轨迹会进入模型训练的数据清单。只有等到大家觉得这类来自专家经验的轨迹逐渐饱和时,才会把免费的羊毛给收回去。收集本身我不反对,要盯的是取得与宣告的方式:这两步走歪了,收到的轨迹越多,问题反而越大。
我们看看当下 AI 成果在学界站到了什么位置:AI 参与科研,有些成果学界是认账的。2024 年诺贝尔化学奖的一半,授给了 Demis Hassabis 与 John Jumper,理由是 AlphaFold2 模型对蛋白质结构的预测10;与之相关的,DeepMind 的 GNoME 在 2023 年一次性给出 220 万种新晶体11。诺贝尔委员会把工具写进了授奖理由,署名与责任仍然留给人。Google 的 AI co-scientist 在抗微生物耐药机制的任务里生成并验证了候选假设12。2026 年 8 月,Anthropic 报告一个未发布的 Claude 研究版把黎曼 函数相关的一个下界从 41.6% 提升到 67.2%,同时说明黎曼假设本身仍未解决13。
这些例子合起来,是一套现成的接纳方式:同行能读懂,结论能被独立验证,最后署名的仍然是人。当然,有的还没走到这一步:黎曼那条,目前只是一份公司研究笔记。AI 能不能做科研,或许只是技术问题;它的成果能不能被承认,要看制度接不接得住。
两起争议:一万个 agent 与一次“自主发现”
这两起事件,出问题的都是“宣告”这一步。第一起发生在 2026 年 9 月 8 日。OpenAI 公告称,其内部模型驱动的一组协调
一位从事强相关领域的数学家,Buckmaster,在当天的声明里说,他问过 OpenAI,模型是否读取过他们在 Codex 里的会话记录,那里放着他们一整个项目的草稿,对方回答说模型不查用户数据;当他追问训练的事时,没有得到回答15。OpenAI 的回应是,在 Buckmaster 一方公开发布之前,研究人员与智能体都没有看到他们的工作,也没有为此访问任何具体的用户数据;但公告的初版里承认,无法排除用户使用中留下的去标识化数据帮助改进了模型16。这是典型的各执一词,一方陈述自己听到的话,一方给出自己调查的结论。
这件事里还有一层更早的争议:
此后两周里,争论转向了问题本身:这到底是不是他们真正关心的那个问题?9 月 17 日,Constantin、Ignatova 与 Vicol 的预印本进一步表明,这套外力构造无法推广到去掉外力的原始问题17。Luis Silvestre 说得直白:“The most important problem is unsolved.”(最重要的那个问题还没有解决)。作为一个局外人,我们只能判断:他们解的不是同一道题,“外力”这个限定条件不是可以略过的细节,意味着 OpenAI 宣称的这个结果并不是人类方法的简单外推;但同时,我们也无法判断,其解题过程在多大程度上受到启发或更加直接的帮助。
第二起发生在 9 月 23 日。Anthropic 公告称,Claude 发现了一个性质上与 CRISPR 相似的新酶系统;官方的说法是,科学家只给了一句高层级的方向提示,搜索与候选筛选由智能体自主完成。公告同时写明,所有湿实验由人类科学家完成18。规模是约 950 个智能体、21 小时、2.1 亿 token,从 20 万余个逆转录酶里筛出约 3,500 个候选系统。所谓“自主”,说的是搜索与假设生成,不是无人干预;这个系统有什么用,现在还没人说得清,预印本也未经同行评审。
质疑来得很快,而且具名。9 月 27 日,哥本哈根大学计算生物学家 Mario Rodríguez Mestre 对《纽约时报》说,他的团队已经研究这类酶四年。过去三年里,他们一边用 Anthropic 的模型写代码、起草稿件,一边把该系统的关键发现分享给 Anthropic,他担心这些信息被用于训练后续模型19。
哈佛医学院的 Philip Kranzusch 对此评价为:“It’s not yet a breakthrough. It’s a wrinkle on what we know in the field.”20(这还够不上一次突破,只是在已知的地图上多画了一笔)。华盛顿大学的 Kevin Blake 说得更直接:没有任何迹象表明这个系统能与 CRISPR 的基因编辑技术相比,更谈不上成药21。先发一个亮眼的公告声明,随后才放证据;等到真正核对的时候,群众对其的印象已经形成了。两起事件里,质疑者都具名,都来自大学,问的主要是两类问题:一类追问来源,数据从哪来、谁先到;一类掂量价值,这算不算一次突破。两类质疑看似不同,追究下去都卡在同一处:来源查不清,功劳就算不明白。
| OpenAI - Navier–Stokes | Anthropic - ART 酶系统 | |
|---|---|---|
| 官方口径 | 约一万个并发智能体;证明有限时间奇点;Lean 验证;不申领千禧年奖14 | 仅一句高层级方向提示;湿实验由人类科学家完成;950 个智能体、21 小时18 |
| 核心质疑 | 是否接触过对方的草稿与训练数据15 | 该酶已被研究四年,关键发现是否被用于训练19 |
| 质疑者与身份 | Tristan Buckmaster,NYU 数学教授 | Mario Rodríguez Mestre,哥本哈根大学 |
| 关键时间差 | 对方发布声明约 12 小时后才公告22 | 9 月 23 日公告,9 月 27 日质疑见报 |
| 后续进展 | 数学家质疑是否解错了问题;预印本指该构造无法推广17 | 功能未知、预印本未经同行评审;评价是“还不是突破”20 |
| 是否承认对方优先权 | 是(仅限相关问题),公告明确承认并致贺14 | 未涉及 |
陶哲轩在 9 月 8 日就写过这种宣告的长期代价:现在连“有人在研究某个问题”的传闻,都能触发一场大规模、AI 驱动的行动,抢在原始项目长大之前把问题解决掉;激励可能正在转向不再分享研究方向,而这会逆转几个世纪的开放科学传统4。担心这种宣告方式的不止他一个。25 位菲尔兹奖得主在联署声明里写道:“As in all creative professions, this raises severe attribution and plagiarism questions.”23 说的是仓促宣告下的归属与抄袭问题。
这两件事放在一起,我们不难得出一个判断:这两家公司选的不是把工作做完整,而是抢一个足够大的新闻标题。不是单纯为了集体的知识进步,而是一个“我要跑得比你更快”的商业游戏。当然,这是推演,不是指控。OpenAI 也承认这项工作是在听到一个传闻之后启动的14,Buckmaster 则在声明里记下了交涉中的一问一答:他反对那样的发布安排,对方回了一句,为什么要毁掉自己的前途?15
这两件事暴露的问题在机制,不在道德:“成果宣告”与“可追溯的来源”之间缺了一环。
引用、致谢与一套脆弱的机制
科研靠什么让“公开来源”成为理性选择?答案不是道德,而是一套制度:让成果与它的来路,都留在能被查到的地方。Merton 在 1942 年把现代科学的伦理概括为四组规范,后人缩写为 CUDOS,即
公有性听起来像理想主义,但它有很实际的功能:后来者不必把前人走过的路再走一遍,只要顺着引用找到那项工作。致谢栏管的是另一类贡献:有人说了话、但没有写进方法,这些帮助会被记在公开文本里,成本很低,收益是让合作可以持续。这套规范没有写进任何法律,却每天都有人在成千上万篇论文的引用格式里执行它。
引用网络的特别之处在于它可核对、可低成本验证:一段引文对应一份文本,一份文本对应一个时间戳,谁先说、谁后说,大多能查得出来。整套机制就架在这上面。
同时,这套机制有一个脆弱的支点。Merton 在 1957 年论证过:优先权之争不是人性自私的产物,它出自科学奖励制度对“原创性”的推崇25。只要“原创”是奖励的依据,公开来源就始终伴随风险。
与公有性相对的反规范是保密。后续研究指出,科学家会把最新发现藏着,以确保发表、专利或应用上的优先权26。这像一场博弈:所有人都公开,协作最划算;只有我一个人公开,我先吃亏;只有我一个人不公开,我占便宜;等到人人都不公开,谁都拿不出可核对的记录,谁先谁后,从此无从证明。从纳什均衡的简单博弈角度来看,没有理性人能够独自逃离最后这种情况。
公开来源对个人也不全是付出,也有收获:它把自己的贡献写进公共记录,学术声誉就是从这些记录里长出来的。声誉不能自封,只能被别人引用出来,所以,尽管有优先权上的风险,公开来源对个人仍然划算。
目前,引用与致谢这套机制暂时没有崩:旧账未必当场算清,规则却在一次次被补。AI 带来的新问题,要打的就是这类补丁:
在历史上,这些规范也曾被破坏过。1952 年 5 月,Rosalind Franklin 与 Raymond Gosling 在伦敦国王学院拍下那张著名的 X 射线衍射图。1953 年 1 月,Wilkins 把它出示给 Watson,双螺旋结构据此推出,而 Franklin 的数据,没有征得她同意就被用了28。而后来的事众所周知,Watson、Crick 和 Wilkins 三人因这项成果拿了 1962 年诺贝尔生理学或医学奖,Franklin 不在名单上。另一次压力测试来自 2015 年的心理学。约 270 位研究者协作重复了 100 项已发表研究:原始研究里 97% 得到统计显著结果,重复实验里只有 36%29。之后是一轮漫长的争吵,再之后是预注册、数据共享与开放科学实践的推广。机制失效的后果不是科学停摆,而是一次制度改革。
因此,这套机制虽然脆弱,但至少可以修复,因为它从来不是靠人性撑住的。这些制度都长在人与人之间。只是 AI 进来以后,每一环都有一个对不上的地方。
当协作者不再是人类
对不上的地方从语料开始。模型读过所有人的论文,包括那些还没有发表的草稿吗?这个问题很难有干净的答案。前面引过的那份公告,初版里留了一句:无法排除去标识化的用户使用数据帮过模型的忙16。这句话出自被质疑的一方。即便是模型训练方,也无法——或者不愿——评估模型得到的结果在多大程度上受了这些数据的影响。
训练语料的边界在哪里,多数厂商并不公开:他们公开的只是模型能力,不是读过哪些文本、哪些对话;哪怕主流的开源厂商也是如此,仅仅停留在 L3 级别(参见此前有关大模型的开源分级)。我们能核对的东西比想象中少得多,公开的清单没有,第三方的审计也没有。
如果“
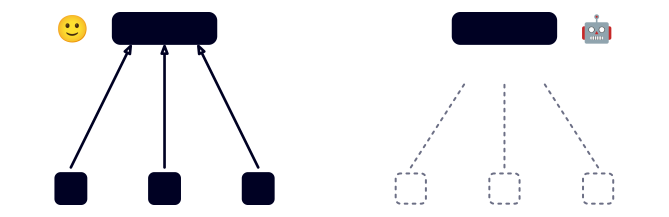
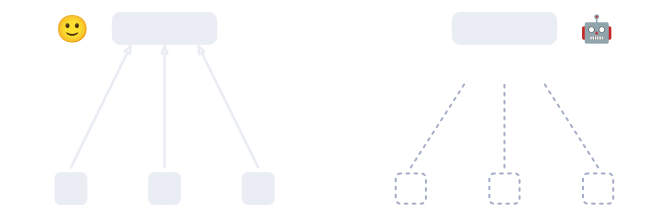
追责链是另一处对不上的地方。眼下的两起争议还有大量媒体关注,有人逐条核对,有人公开声明。但设想一下:某天,一份成果不再有媒体盯着,没有记者去追问研究者的日志,也没有人能把预印本的时间戳和对话记录摆在一起,那时追责靠什么?这是一个思想实验,但它不是空想:AI 生成文章的速度已经开始超过逐篇核查的速度,就连世界最大的预印本网站也不再接受未经同行评议的计算机领域综述和观点类文章30。
可追溯与不可追溯
(左)纯人类写作:来源可查,每一条引用关系都能核对。
(右)AI 参与:文字与想法来源不完全可考,产生幽灵引用乃至虚构引用。
可追溯与不可追溯
(左)纯人类写作:来源可查,每一条引用关系都能核对。
(右)AI 参与:文字与想法来源不完全可考,产生幽灵引用乃至虚构引用。
退一步说,即便我们能够查清楚,追溯那些缺失的引用,代价也不对称:查清需要几个月,而生成只需要几天。
剩下的一处更根本,是协作者的身份。今天 AI 之于科研,多数时候还是“代步工具”,你骑着它,你决定去哪,出了事你负责。大趋势却是把它变成“协作者”:它给出判断,人只负责确认,责任也就散到了个人无法掌控的范围里。重点不在于它是不是工具,而在于关系变了:工具出错,由人负责;协作者出错,责任也不能交给它。责任的落点必须是人,制度上早就写清楚了。
这些对不上的地方,还有一个后果,可以叫神格化:当一个系统被反复称作“发现者”,人们的提问方式就变了。不再问“它读到了什么”,而问“它想到了什么”;从帮助加速科研,到祈求科研成果之间,似乎只隔了一堵矮墙。当我们的提问方式变了,追问的来源和依据,也跟着一起消失了。
我们可以接受一个会犯错的助手,也可以接受一个有边界的产品,难的是接受一个说不清读过什么、也无法被追问判断依据的合作者。署名与责任的规则并不缺,只是都停在论文这一层:研究者的自觉只管得了个人层面的事,而协作者的判断已经进了研究流程,这条流程里却没有人签字担责。
这种对来路的怀疑不需要阴谋论来喂养:只要来源无法被核对,我们既排除不了误用,也排除不了巧合。次数一多,信任就只剩一个问题:默认相信,还是默认不信。
这种危机损害的甚至不是已有的信任,而是一种从未被建立起来的信任。人与人之间的信任,还靠着几个世纪的规范与制度撑着,人与 AI 之间,连规范的对象都还没定义清楚。怀疑因此像一颗带毒的种子:它刚冒头的时候,多数人只是私下议论,等它长成参天大树,被破坏的就不只是一篇论文,是整个科研体系的信任机制。
双向退出
如果要设想一个能够作为解药的制度,它应该长什么样?我能想到的答案只有一句:双向退出。
这个词是我自己造的:
首先要统一门槛:来源没法核对的时候,不论出自谁,我们都不再把 AI 的成果当成已经属于共同体的知识;期刊遇到这类成果,要单独标注、审查更严。
退出的一头对着 AI 公司与它们的成果。对不遵守科研规范的 AI 与背后的公司,共同体可以停止提供数据:研究者可以不把新的科研轨迹继续喂给它们;也可以不再默认信任它们的成果。
另一头对着研究者。借助 AI 灌水、伪造引用、把 AI 生成的内容当作自己的原创而不披露,这些行为大多有现成的处理机制可以接:不披露 AI 使用,可以按期刊规则认定为
对研究者这一侧的督促更难,我也没有一步到位的办法:灌水与隐性剽窃的边界并不总是清晰。缺的是更清楚的披露规范,不是更重的道德指责。把“用了什么工具、做了哪些环节、数据来自哪里”写进方法部分,比笼统声明一句“本研究使用了 AI”要具体得多,也更容易执行。做认定的人也不必来自新机构,期刊与资助机构在具体个案里就能判断,就像今天处理抄袭与伪造引用那样。只是会慢一些。
这个主张需要的东西,大多已经在运行。署名与披露的规则写在期刊要求里,伪造引用有识别与处理的流程。一项分析显示,2026 年 PubMed 收录的论文里,大约每 277 篇就有 1 篇含伪造参考文献,而这只是最容易发现的一类31。心理学那场
这套机制之所以可能奏效,是因为它改的是成本结构:违规的收益眼前就能拿到,而且归个人;成本却要由集体慢慢承担,见效也慢。收益快、成本慢,是眼下失衡的天平。只要让代价先于收益出现,理性的人自然会换一种选法,而这一步不需要说服每一个人。它还有一个附带的好处:把“要不要用 AI、怎么用 AI”从个人偏好,变成可以讨论、可以要求、也可以检验的公共问题。要做到这些,不需要一场道德运动,只需要让守规矩的人不吃亏。
自发的组织是起点:期刊编辑可以要求作者声明 AI 的使用范围,学会可以在评审流程里加一道来源核查,实验室可以与厂商就数据使用签订更明确的条款。
公共系统是下一步:主要资助机构与期刊采用同一套披露要求之后,厂商面对的就不再是几十个实验室各自的谈判,而是一道统一的门槛,退出也就从个人选择变成了制度后果。
担心这会伤到开放科学?反过来才对:公开来源之所以值得,是因为不公开有代价。如果这个代价消失,剩下的就只有一场“谁先收满数据”的竞赛。这道题不新,前一篇中我们就谈过制度与分配。
科研轨迹的数据注定要被收集。我关心的问题是,收集的时候,信任会不会被一起收走。
结语
事实层面已经非常清楚:AI 正在进入科研,轨迹数据正在被收集,价格与席位都摆在那里。机制也不复杂,科研靠引用与致谢构成的可追溯性运转,每一环都要求来源经得起核对。制度设计也只有一条主张:明确门槛,加设退出机制,来源无法核对的不算既有知识,不守规范的要支付成本。
科研的来路,那些论文里从来不写的岔路与断头路,第一次有机会留下连续的记录。这批数据的分量就在这里:双向退出针对的是取得与宣告的方式,不是收集本身。
设想十年之后的一篇论文。它的致谢栏里多出一行:“本研究的部分过程不可追溯。”审稿人可能已经习惯,读者可能也不会多看一眼。到那时,我们还相不相信“AI 发现”这个说法?
神龙可以见首不见尾,但飞过哪片天,共同体总要知道。
参考资料
Footnotes
Ars Technica 关于 2022 年 12 月 ArtStation 艺术家抗议的报道,原文(导语):“On Tuesday, members of the online community ArtStation began widely protesting AI-generated artwork by placing ‘No AI Art’ images in their portfolios.” https://arstechnica.com/information-technology/2022/12/artstation-artists-stage-mass-protest-against-ai-generated-artwork ↩
Adobe 官方博客 “Adobe partners with artists to power the new era of media & entertainment with Firefly Foundry”(2026-01-22),记录专业影视制作流程中 AI 工具的合作落地。https://blog.adobe.com/en/publish/2026/01/22/adobe-partners-artists-power-new-era-media-entertainment-firefly-foundry ↩
音乐产业 AI 版权诉讼进展:UMG 于 2025 年 10 月与 Udio 和解并签订授权协议,Warner 于 2025 年 11 月与 Suno 和解;Sony 未和解。Suno 系列诉讼仍在马萨诸塞州联邦法院进行(UMG v. Suno,案号 1:24-cv-11611,D. Mass.),Law Commentary 报道原文:“Both copyright cases remain pending in Massachusetts federal court.”;2026 年 3 月,独立音乐人另案起诉 Google(Lyria 3、ProducerAI),起诉书案号 1:26-cv-02582、2026-03-06 提交,全文由 Loevy 公布。https://copyrightalliance.org/ai-copyright-lawsuit-developments-2025;https://www.lawcommentary.com/articles/umg-sony-suno-ai-copyright-lawsuit-v6;https://www.casemine.com/judgement/us/69d7ab2f64eb89b6c2004c31;https://www.loevy.com/wp-content/uploads/2026/03/Kogon-v.-Google.-Complaint-Filed-1.pdf ↩ ↩2
Terence Tao 在 Mathstodon 上关于 AI 与数学协作前景的评论(2026-09-08),原文:“it is now the identification of a promising problem which is the scarce and precious resource. We have now seen that even the rumor of someone working on a problem can trigger a massive amount of AI-powered effort to flatten it before the original research project has time to reach its full potential. The incentives may now be pointing in the direction of no longer sharing any promising research directions with the broader community, which would reverse centuries of traditions of open science and do serious long-term damage to the future of the field.” https://mathstodon.xyz/@tao/117237322160500501 ↩ ↩2
专家数据市场的规模:据 Dealroom 报道,Mercor 于 2026 年 6 月达到超过 20 亿美元的 gross annualized revenue(年初为 10 亿);Dealroom 原文:“It now pays over $2 million a day to more than 30,000 weekly active contractors.”,并注明该口径 “reflects total customer spend before contractor payouts, not net revenue retained”(付给专家之前的总流水,不是净收入)。Mercor 官方博客(2026-05-08)自述:“we pay out over $2 million every day to more than 30,000 weekly active contractors across the world.” https://app.dealroom.co/news/note/mercor-doubles-to-2b-gross-revenue-run-rate-as-ai-labs-buy-expert-data;https://www.mercor.com/blog/when-you-go-from-2-million-a-month-to-2-million-a-day/ ↩
Anthropic 官方公告 “Expanding our support for scientists”(2026-08-27),原文:“We are opening 10,000 seats for scientists around the world to access Claude subscriptions for free and at discounted rates for one year… Standard seats will be free and premium seats with 5x usage limits will be available for $15 per month.”;公告还写道:“Over the coming months, we intend to extend this program well beyond the initial 10,000 seats.”;AI for Science 项目单项目额度上限为 5 万美元。https://www.anthropic.com/news/expanding-support-for-scientists ↩
Anthropic 官方公告 “Claude Science, an AI workbench for scientists”(2026-06-30),官方描述该产品 “produces auditable artifacts”,即把科研过程沉淀为可审计的产物;Anthropic 自身的酶发现工作即在此工作台与 Claude Code 中完成。https://www.anthropic.com/news/claude-science-ai-workbench ↩
xAI 官方发布 “Grok Code Fast 1”(2025-08-28),原文:“We’ve teamed up with select launch partners to offer `grok-code-fast-1` for free for a limited time, including GitHub Copilot, Cursor, Cline, Roo Code, Kilo Code, opencode, and Windsurf.”;API 定价为每百万输入 token $0.20、每百万输出 token $1.50。https://x.ai/news/grok-code-fast-1 ↩
Google 官方 Gemini CLI 文档:个人 Google 账号可获免费额度 “60 requests/min and 1,000 requests/day with personal Google account”,含 1M token 上下文。https://google-gemini.github.io/gemini-cli ↩
2024 年诺贝尔化学奖授予 David Baker(计算蛋白质设计,占一半)以及 Demis Hassabis 与 John M. Jumper(蛋白质结构预测,共占一半)。诺奖官方原文:“In 2020, Demis Hassabis and John Jumper presented an AI model called AlphaFold2. With its help, they have been able to predict the structure of virtually all the 200 million proteins that researchers have identified.” https://www.nobelprize.org/prizes/chemistry/2024/press-release ↩
Google DeepMind 于 2023 年 11 月 29 日在 Nature 发表 GNoME(Graph Networks for Materials Exploration),发现 220 万种新晶体结构。https://deepmind.google/blog/millions-of-new-materials-discovered-with-deep-learning ↩
Google 于 2025 年 2 月发布 AI co-scientist,基于 Gemini 2.0 的多智能体系统用于生成与排序科研假设,并在抗微生物耐药性机制的验证任务中复现了关键假说;合作论文见 Penadés et al., Cell, 2025。https://research.google/blog/accelerating-scientific-breakthroughs-with-an-ai-co-scientist ↩
Anthropic 研究笔记(2026-08-10):一个未发布的 Claude 研究版把黎曼 ζ 函数相关的一个下界从 41.6% 推进到 67.2%,Anthropic 明确说明黎曼假设本身仍未解决。https://www.anthropic.com/research/riemann-zeta ↩
OpenAI 官方公告 “On the Navier–Stokes Millennium Prize Problem”(2026-09-08,09-10 更新):其内部模型驱动的协调智能体系统证明了三维不可压缩 Navier–Stokes 方程存在有限时间奇点,并在 Lean 中完成形式化验证。原文:“the group that produced the Navier–Stokes resolution involved on the order of 10,000 concurrent agents”;公告还写道 “Our effort began on September 1st after hearing a rumor which we later realized was related to Levent Alpöge, an Anthropic employee, and Tristan Buckmaster, a math professor at NYU.”;公告同时写明 “We do not intend to claim the Millennium Prize for this result.”,并把 C、D 两支写进结果表述:“we suggested versions ‘A’ and ‘B’ (particular forms of the Navier–Stokes problem which would result in a proof) and versions ‘C’ and ‘D’ (which would result in a disproof)”,“This resolves the Navier–Stokes Millennium Prize problem by establishing statement ‘C’ (and also ‘D’) in the official Millennium Prize formulation.”;公告同时写道:“We recognize the priority of their work on forced Euler and congratulate them on their remarkable mathematical achievement.” https://openai.com/index/navier-stokes-solution ↩ ↩2 ↩3 ↩4 ↩5
Tristan Buckmaster(NYU)就优先权争议发布的公开声明(2026-09-08),原文:“I asked whether the model had been trained on, or had access to, our sessions in Codex, into which we had been putting all our drafts for the whole of this project. I was told the model did not look up user data. I asked again, about training, and I did not get an answer.”;声明还记录了一场交涉中的回应:“I said that if OpenAI released its result in the way proposed I would go public with what happened. The reply was, ‘Why would you ruin your career?’”;同一声明写道 “The route to the Clay problem through a smooth force, options c and d in Fefferman’s statement of the problem, is the route Luis and Diego opened and the one Levent and I had quietly chosen to attack. Almost nobody else I know of was working on it.” https://cims.nyu.edu/~tristanb/statement.pdf ↩ ↩2 ↩3 ↩4
OpenAI 就同一争议的回应(初版公告 2026-09-08):“We (the researchers and the agents) did not see any of their work through any means until they released it publicly — in particular, no specific user data was accessed in order to solve this problem. While unlikely, we cannot rule out that de-identified data derived from their usage of our products helped improve our models.”;其中 “While unlikely…” 一句在 09-10 更新后已从现版页面移除。初版快照:https://web.archive.org/web/20260908171518/https://openai.com/index/navier-stokes-solution;现版:https://openai.com/index/navier-stokes-solution ↩ ↩2
Scientific American 报道数学家质疑 OpenAI 是否解了「正确」的 Navier–Stokes 问题(2026-09-21),Luis Silvestre 原文:“The most important problem is unsolved. The Clay problem is settled, but the main problem for the Navier–Stokes equations is not.”;Constantin、Ignatova、Vicol 于 2026-09-17 投递 arXiv:2609.20803,证明该外力构造无法推广。https://www.scientificamerican.com/article/did-openai-solve-the-wrong-navier-stokes-problem ↩ ↩2
Anthropic 官方公告 “Claude discovers a novel enzyme system with CRISPR-like repeats”(2026-09-23),原文:“Claude discovered a novel enzyme system with properties reminiscent of CRISPR, with only high-level direction from our scientists”,并明确 “All of the lab work is performed by human scientists.”;文中约 950 个智能体、21 小时、2.1 亿 token 完成搜索,系统命名为 ART(array-associated reverse transcriptases),功能仍未知,预印本未经同行评审。https://www.anthropic.com/news/claude-discovers-novel-enzyme-system ↩ ↩2
哥本哈根大学计算生物学家 Mario Rodríguez Mestre 于 2026-09-27 对《纽约时报》表示,其团队已研究 ART 类酶四年,且过去三年在使用 Anthropic 模型的过程中向对方分享了关键发现。原文:“So, for me, the most important question is not ‘Were ARTs already known?’ They were.”;“My concern is that this information was used to train future versions of the models.” https://www.nytimes.com/2026/09/27/science/anthropic-biology-enzyme-mestre.html ↩ ↩2
哈佛医学院微生物学家 Philip Kranzusch 对同一发现的评价(NYT,2026-09-24),原文:“It’s not yet a breakthrough. It’s a wrinkle on what we know in the field.” https://www.nytimes.com/2026/09/24/science/anthropic-biology-lab-enzyme.html ↩ ↩2
华盛顿大学医学院微生物学家 Kevin Blake 对 Al Jazeera 表示(2026-09-24),原文:“There’s nothing to indicate this is a rival to CRISPR-the-technology, or could be developed into any kind of therapeutic or practical application.” https://www.aljazeera.com/economy/2026/9/24/ai-model-claude-discovers-crispr-like-enzyme-system-anthropic-says ↩
关键时间差来源:Quanta Magazine 报道(2026-09-08)原文:“The OpenAI announcement of this long-sought singularity came 12 hours after an announcement from Tristan Buckmaster at New York University that he, together with Levent Alpöge at Anthropic, had resolved several closely related problems.”;维基百科《Navier–Stokes priority controversy》(第三方汇编,含原帖引注)同载 “an announcement on 8 September, approximately 12 hours after Buckmaster’s post.” https://www.quantamagazine.org/ai-has-solved-one-of-maths-1-million-millennium-prize-problems-20260908;https://en.wikipedia.org/wiki/Navier%E2%80%93Stokes_priority_controversy ↩
25 位菲尔兹奖得主联署声明 “A Severe Misalignment of AI in Mathematics”(2026-09-11,DOI 10.5281/zenodo.22737750),原文:“Often these solutions are announced in a rush, leaving no time for a proper writeup, the isolation of new methods and ideas, and citing relevant previous work of others. As in all creative professions, this raises severe attribution and plagiarism questions.” https://mathandai.org/ ↩
Robert K. Merton “The Normative Structure of Science”(1942,原题 “A Note on Science and Technology in a Democratic Order”)提出科学的四组制度性规范,即 CUDOS,原文:“Four sets of institutional imperatives - universalism, communism, disinterestedness, organized skepticism - are taken to comprise the ethos of modern science.” 其中 communism(公有性)要求科学知识属于共同体,研究者须公开成果并承认来源。https://www.panarchy.org/merton/science.html ↩
Robert K. Merton “Priorities in Scientific Discovery: A Chapter in the Sociology of Science”,American Sociological Review 22(6): 635–659, 1957:论证优先权之争不是「人性自我中心」的偶然产物,而是由科学奖励制度对「原创性」的推崇结构性地产生,也就是「公开来源」与「保住优先权」之间的张力。https://www.academia.edu/34402380/Merton_Robert_K_1957_Priorities_in_Scientific_Discovery ↩
Merton 的规范在 1970 年代后被批评为描述性不成立,与 communism 相对的反规范是 secrecy,原文:“Scientists protect their newest findings to ensure priority in publishing, patenting, or applications.” https://en.wikipedia.org/wiki/Mertonian_norms ↩
ICMJE(国际医学期刊编辑委员会)关于作者使用 AI 的建议,原文:“Chatbots (such as ChatGPT) and other AI-assisted tools should not be listed as authors because they cannot be responsible for the accuracy, integrity, and originality of the work…”;“Referencing AI-generated material as the primary source is not acceptable.”;“Nondisclosure of AI use may require corrective action and may be construed as misconduct in some circumstances.” https://www.icmje.org/recommendations/browse/artificial-intelligence/ai-use-by-authors.html ↩ ↩2
Rosalind Franklin 与 Raymond Gosling 于 1952 年 5 月 2 日在伦敦国王学院拍摄的 X 射线衍射图「Photograph 51」;1953 年 1 月 Wilkins 将该图出示给 Watson,Watson 与 Crick 据此推出 DNA 双螺旋结构,Franklin 的数据在未获其同意的情况下被使用。https://www.kcl.ac.uk/the-story-behind-photograph-51 ↩
Open Science Collaboration(约 270 位研究者协作)“Estimating the reproducibility of psychological science”,Science 349(6251): aac4716, 2015,摘要原文:“Ninety-seven percent of original studies had statistically significant results. Thirty-six percent of replications had statistically significant results.”;该危机随后推动了预注册、数据共享等制度性改革。https://www.science.org/doi/10.1126/science.aac4716;https://www.cos.io/about/news/massive-collaboration-testing-reproducibility-psychology-studies-publishes-findings ↩ ↩2
2025 年 10 月 31 日,arxiv 发布官方声明,所有计算机类别下的综述、观点类论文必须发表在经过同行评议的期刊或会议上,才可进入其预印本仓库。理由写的正是:“In the past few years, arXiv has been flooded with papers. Generative AI / large language models have added to this flood by making papers – especially papers not introducing new research results – fast and easy to write.” https://blog.arxiv.org/2025/10/31/attention-authors-updated-practice-for-review-articles-and-position-papers-in-arxiv-cs-category/ ↩
Retraction Watch 报道的一项分析(2026-05-07):2026 年 PubMed 收录论文中约每 277 篇有 1 篇含伪造参考文献;该分析出自哥伦比亚大学 Max Topaz 等致 The Lancet 的通讯,西北大学的 Mohammad Hosseini 评论称这一数字是 “low-hanging fruit” 与 “tip of the iceberg”,“bigger and more important problem” 是不准确或有偏的 AI 生成引用。https://retractionwatch.com/2026/05/07/one-in-277-pubmed-indexed-papers-in-2026-shows-fabricated-references-says-analysis ↩